Smart Note - MCP 让AI看到我笔记
# 前言
从复制粘贴,到一句话落进目录
上周想让 AI 把手里这篇方案改一版。方案在我的笔记本里。
于是我打开笔记软件,找到它,全选,复制,切回对话框,粘贴,说要改什么,等它写完,再全选复制,切回去,覆盖原文。
改完算了一下中间那几步:和 AI 的能力一点关系都没有。它只是在做一件它做不到的事,读我硬盘上的一份笔记。
现在这件事变了。我可以直接说「把上周那篇方案按这个思路改一版」,它自己搜到、读完、把改好的版本盖回去。查资料也一样:它在我的笔记里翻,答完顺手把结论整理成一页放进目录,下周用关键词就能找回来。
这背后是 MCP(Model Context Protocol),一个让 AI 助手调用外部工具的协议。协议本身没什么可讲的,值得讲的是接上之后,笔记这件事多了哪几种用法,以及为此付出了什么。
# 三件以前要手工搬的事
第一件,查完就记。
你让 AI 查一个东西、回答一个问题,然后说「整理成一页,放进技术 / 技术笔记,标签加上同步和 CRDT」。它自己搜、读、归纳、写、打标签。
以前要六七步:结论在对话框里,你不想让它烂在那儿,于是打开笔记软件、想标题、找目录、粘进去、再补几个标签。这些动作都不难,但得挤进你当时正忙的那件事里。于是大多数时候,它就这么消失了。记一下越贵,笔记越稀。
第二件,基于旧笔记写新版。
以前是找到、打开、全选、复制、粘贴进对话框、描述要求、等它写完、再复制回去覆盖。八步,中间任何一步走神都要重来。
现在一句话。它自己搜到那篇、读完、改完、盖回去。
第三件,回答「我以前关于这件事写过什么」。
以前得自己搜,逐篇打开,全选复制,还得分好几次粘。现在它自己找、自己读,决定读哪几篇,答完把出处带上。
三件事的共同点:以前每一步都要人动手,现在只有「我想要什么」需要人说。
# 记录:一句话落进目录
这条链现在短到一句:
把这五篇里关于离线同步的做法整理成一页,放进「技术 / 技术笔记」,标签加上同步和 CRDT。
几个细节让它真的能天天用。
目录不用你先建。你说「技术 / 技术笔记」,路径不存在,它逐级补建,然后告诉你实际落在了哪。不会悄悄扔进「未分类」让你以后去翻。
同名同目录不会写两遍。重复问同一个问题,它把已有的那篇还给你,而不是攒出一堆「xxx 副本」。
标签按名字自动建。你不用先去标签管理里创建,再回来赋值。
写完立刻能搜到。这一条最容易坏,单说。
AI 写进笔记的数据,和搜索用的数据不是同一份。搜索为了快,会把正文另存一份到索引里。AI 改的是前者,后者不会自己更新。所以「写进去了」和「搜得到」中间还差一步:把新正文回填给搜索。少这一步,笔记打开看得见,搜索框里就是搜不到,列表里的摘要还是空白。
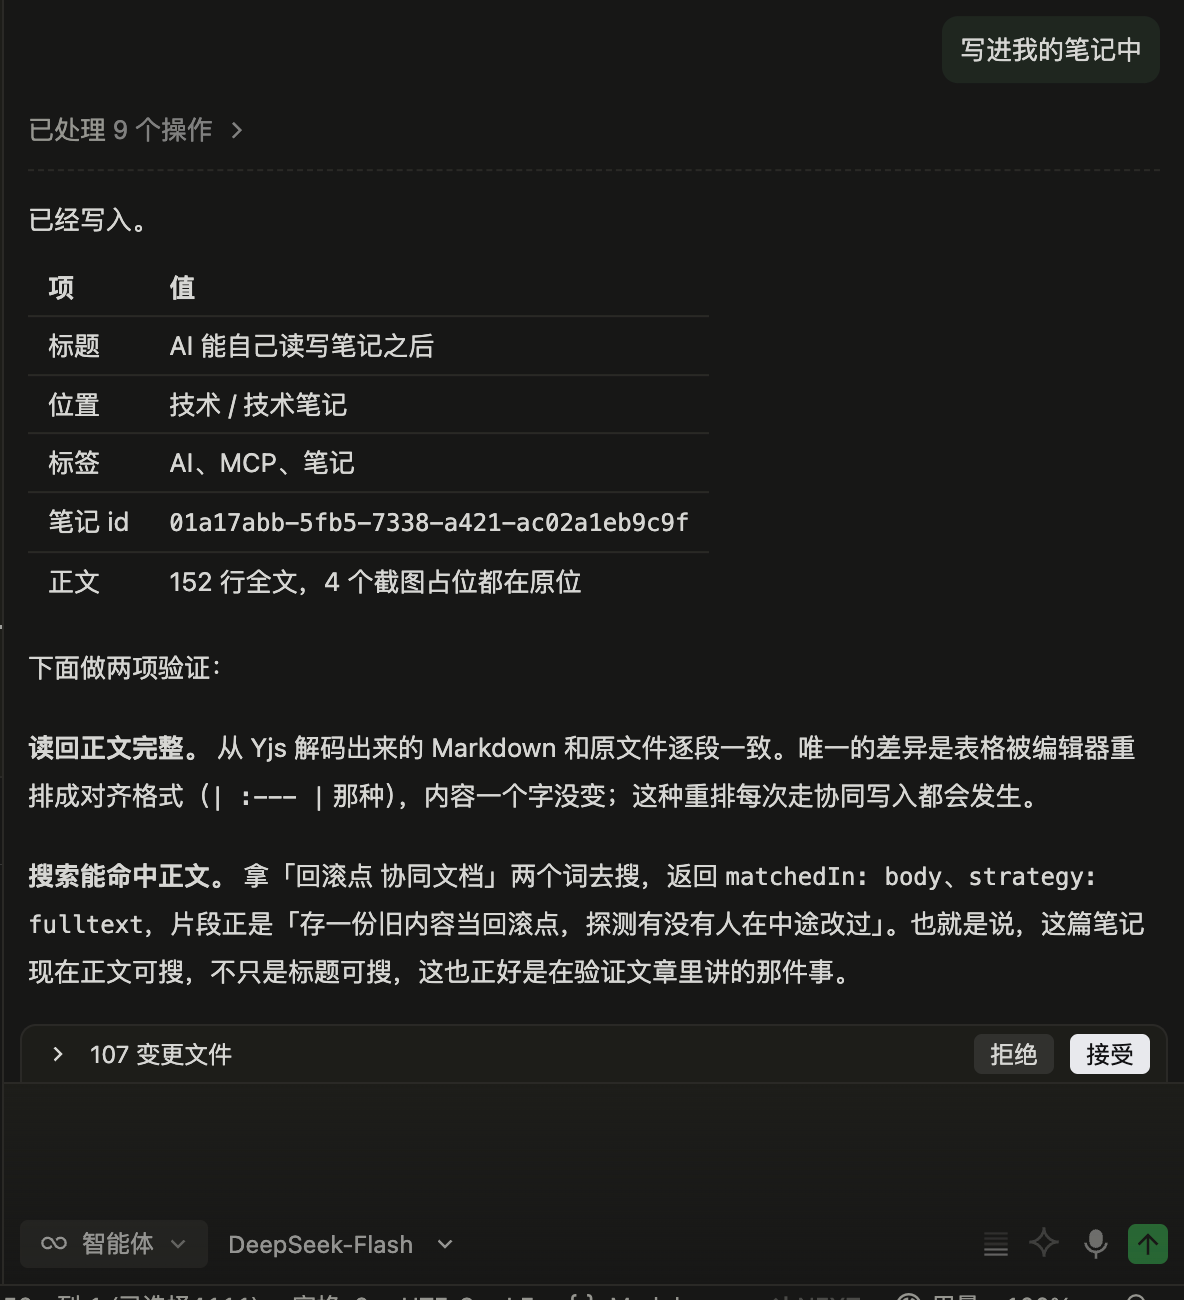
有个限制要说清楚:这样整理出来的笔记带不了图。AI 没有上传附件的能力,图得你自己补进去。
# 搜索:以前其实只搜了标题
很多人以为笔记软件的搜索是全文搜索。不是。正文通常进不了索引,能搜的只有标题和摘要。所以你明明记得写过某个词,搜出来是空的。
这次把正文放进了全文索引。变化很直接:一个只出现在正文里的词,以前一条都返不回来,现在能命中。
搜索结果的形态也变了。以前返回一堆标题,模型和人一样,只能靠标题猜哪篇是要找的。现在每条结果带目录、修改时间,还有正文里命中的那一段。看到片段就知道是不是它,不用一篇篇点开。
多个词按「同时满足」理解。以前输入「离线 同步」,得原文里有这一整串,包括中间那个空格,才算命中,这几乎不是人的搜索习惯。现在拆成两个词求交集。这个改动人和 AI 都受益,软件自己的搜索框也走同一套逻辑。
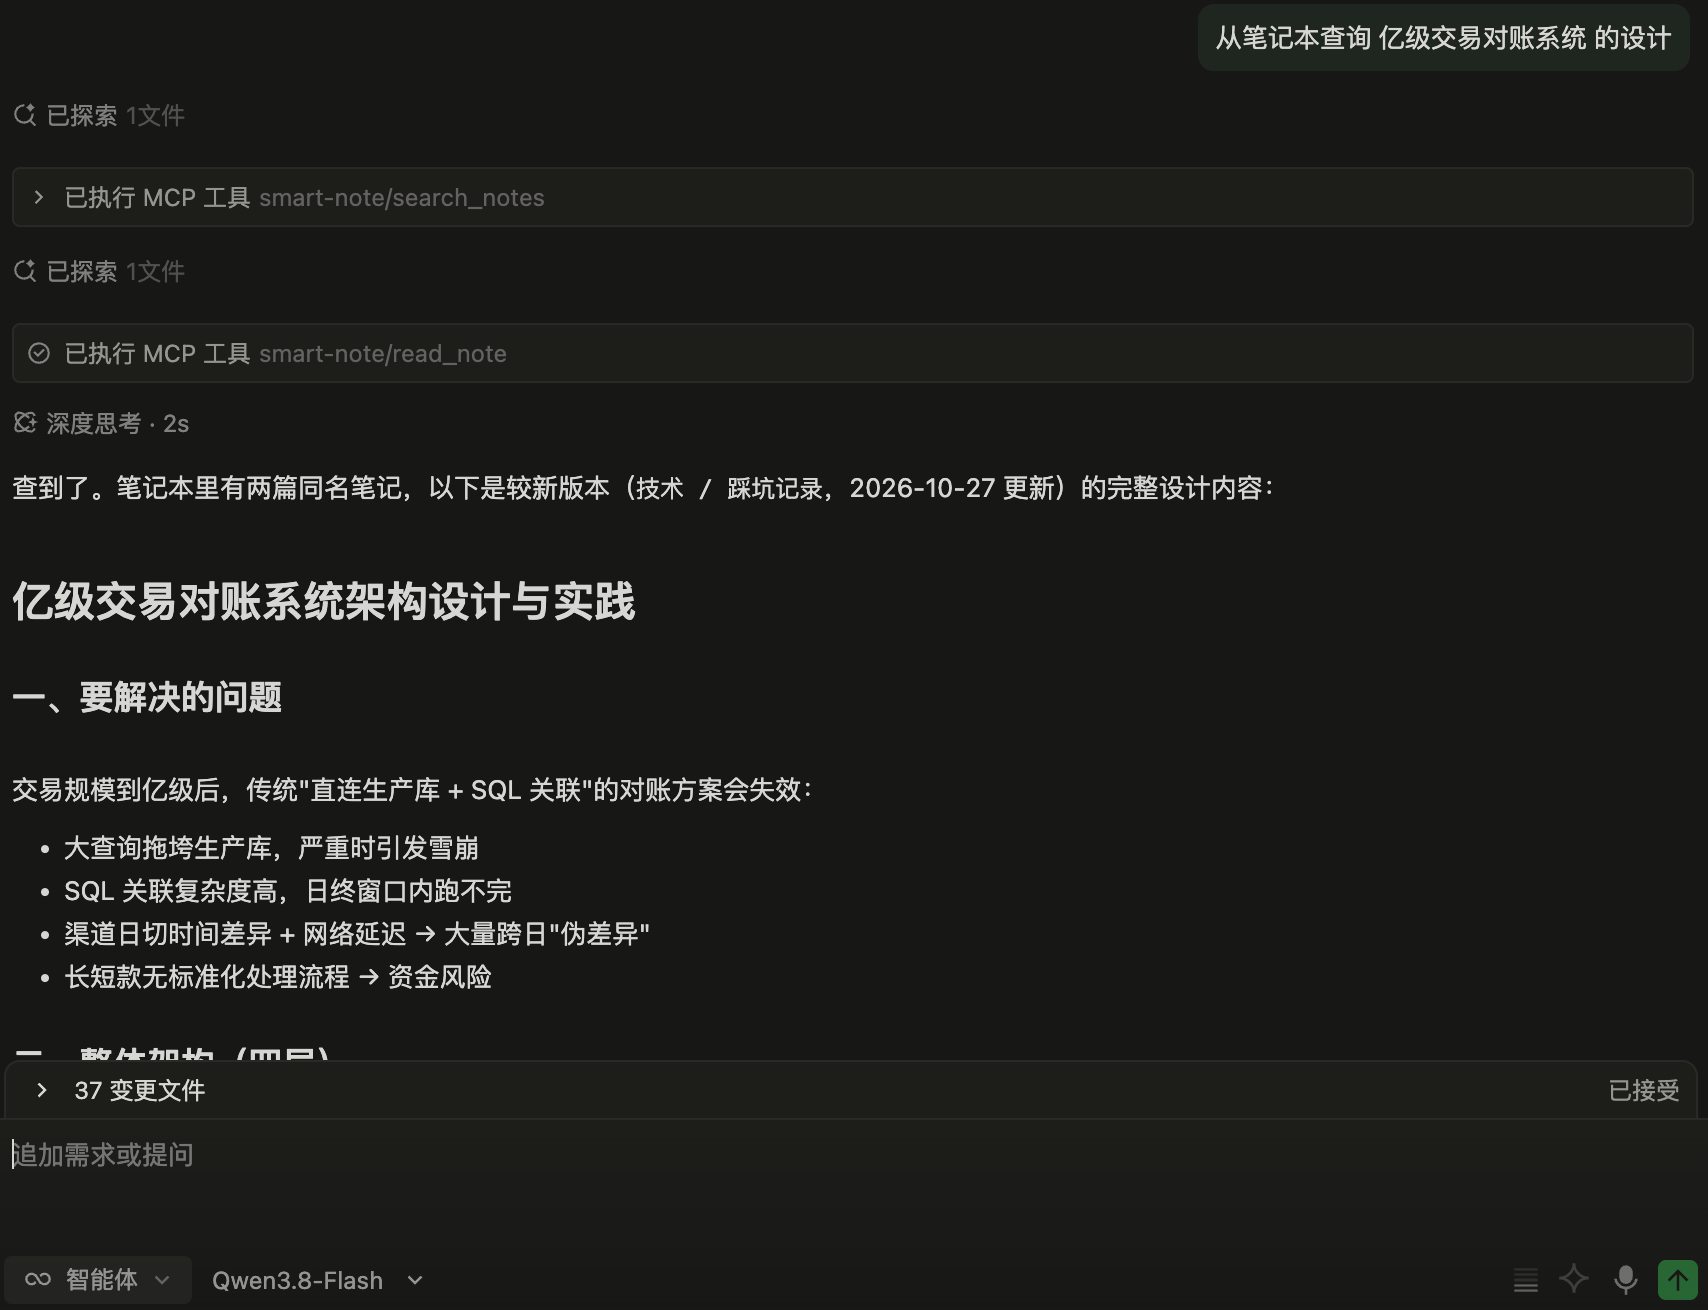
一个诚实的边界:两个字的词搜不到正文。中文没有词边界,不需要词典就能工作的分词方案只有三字符滑窗,代价是查询词不能少于三个字。「架构」「周报」这类两字词切不出可查片段,只能退回标题和摘要。宁可少返结果,也不能让原本搜得到的东西凭空消失。
索引是有成本的:一万篇、约 40MB 正文的库,索引本身 89.7MB,是正文的 2.2 倍。但换来的是覆盖率,不是速度。查一次二三十毫秒,和原来的子串匹配差不多,差别在于能不能搜到。
# 整理:整篇替换,不是往后接
让 AI 润色一篇笔记,最直觉的做法是追加:新版本接在原文末尾,你自己对比。
这是错的。追加出来是一篇既有旧版又有新版的笔记,越改越乱,而没人会去手动删旧的那段。
正确的做法是整篇替换:读旧全文,模型产出新全文,一次盖掉。改写发生在 AI 助手自己的模型里,不在笔记软件里调一个「AI 润色」接口,所以你可以换模型、能看到改了什么,也不依赖软件配了哪家的密钥。
覆盖是破坏性动作,所以顺序有讲究:读旧正文,校验新正文,逐字比对(一样就什么都不做),存一份旧内容当回滚点,探测有没有人在中途改过,最后才写入。回滚点必须在写入之前,这类写入本身不产生历史版本,没有这一步,覆盖就不可撤销。
发现中途有人改过,只提醒不重试。笔记软件会把两边的修改合并起来,但用户正在编辑器里打的字可能被盖掉,AI 不知道该保留谁的,让人来定。
带图的笔记一开始不允许改写,理由是「图片的某些属性没法从 Markdown 还原」。跑了一遍真实读写之后这个说法站不住:图片地址、替代文本、宽度都是无损往返的。危险的地方在于模型看不见图,它把地址改一个字符、或者润色时把图删了,自己不知道。
所以限制换成一条能机器校验的规则:替换前后,图片地址的集合必须完全相等,不计顺序,一处不能少也不能凭空多;标题、说明、位置、宽度随便改,违反就报错。
这条规则比图片本身更通用:能用可校验的不变式,就别用类型黑名单,黑名单会一路往严格的方向滑,直到把本来能安全做的事也禁掉。只有内联密钥仍然禁止整篇替换,模型看到的是占位符,它把两个占位符对调,谁也检查不出来。
# 一句话背后是七步
上面说的都是「一句话」。但一句话落进去,服务器要做这些事:
解析 Markdown,校验里面有没有 AI 写不出来的东西
  → 按「目录 + 标题」查重,已存在就不建,把已有 id 还回去
  → 创建笔记(只能带标题和目录)
  → 把 Markdown 编码成协同文档格式的二进制增量,上传
  → 目录不存在就逐级补建,标签按名字自动建
  → 重新拉一次数据,解码出正文
  → 回写搜索用的正文与摘要
2
3
4
5
6
7
顺序和检查都由服务器保证,不交给模型。模型只需要表达意图。
这些步骤不是凑数的。有一部分失败了也返回成功,只是没做成该做的事:
| 漏掉的那一步 | 坏成了什么样 | 什么时候才发现 |
|---|---|---|
| 编码成协同文档,而不是直接写文本 | 笔记建出来了但正文是空的,或者旧内容复活 | 打开编辑器的那一刻 |
| 回写搜索用的正文与摘要 | 这篇笔记再也搜不到,列表里摘要是空白 | 下次想找它的时候 |
| 先查重再建 | 同名笔记建了两篇 | 翻目录的时候 |
接口返回成功,模型就认为自己成功了,接着往下做。用户要过好几天才发现那些笔记根本搜不到。把编排收进服务器,这些坑就从「模型要记住」变成了「服务器保证」。
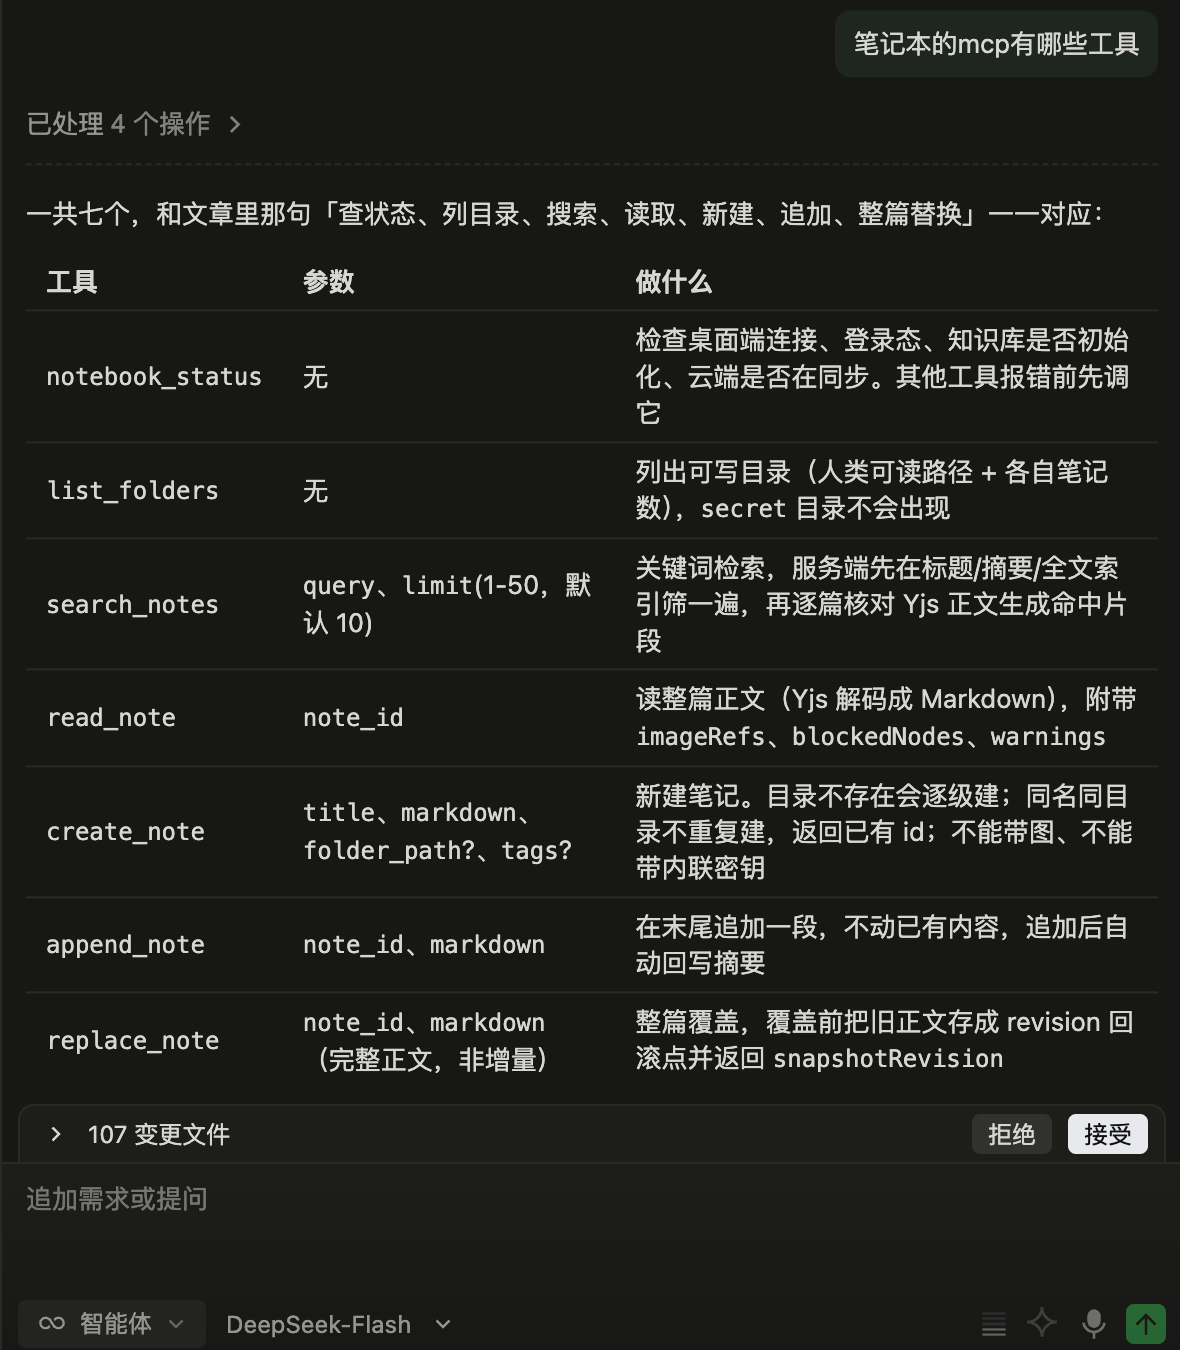
对外一共七个动作:查状态、列目录、搜索、读取、新建、追加、整篇替换。没有删除,没有权限管理,没有一个动作叫「更新正文」。
# 为什么这件事不好做
笔记正文在这个软件里不是一段文本,它是一份协同文档。同一篇笔记在手机上改一段、电脑上改一段,两份副本放一起能自动合并,不丢内容。代价是它不再可读,在数据库里是一堆二进制增量。
三处设计把「直接写正文」这条路堵死了:创建笔记的接口拒收正文,更新笔记的接口只允许改标题和目录,服务端不解析那份二进制,它只负责把字节存下来。
这是设计上对的选择。把 Markdown 变成协同文档,需要知道编辑器的文档结构:哪些算标题、表格单元格归属哪行、图片带哪些属性。这份定义只存在于前端。服务端再实现一遍,两边就会开始漂移,今天是图片少一个属性,明天是嵌套列表算错一层。
于是知道怎么写入正文的代码只有一处:编辑器本身。结论听起来很荒唐,要让 AI 能写笔记,就得让 AI 跑起一个浏览器里的编辑器。工具服务器跑在 Node 里,没有浏览器,最后靠一个模拟浏览器环境的库把编辑器挂了起来。
代价是这个包 71MB。它把一个编辑器塞进了 app 里,用户不用装任何依赖。我们试过三次想把它压成单个文件,全部失败,就停在这了。
# 它不能做什么
先说最硬的一条:它只能连本机。AI 读的是你这台机器上正在运行的那个桌面端,云端和跨设备完全没做。令牌只在本地,别人拿不到,也调不了。
删不了任何东西。令牌按路径白名单放行,只允许读状态、列目录、搜索、读正文、写正文、建目录、打标签,其余一律拒绝。加密目录根本不会列出来,AI 不知道它存在。这个软件没有回收站,所以在有回收站之前,不提供不可逆动作。
带不了图。新建和追加的内容里不允许带图片,因为 AI 没有上传附件的能力,带进去就是一张永远坏掉的图。
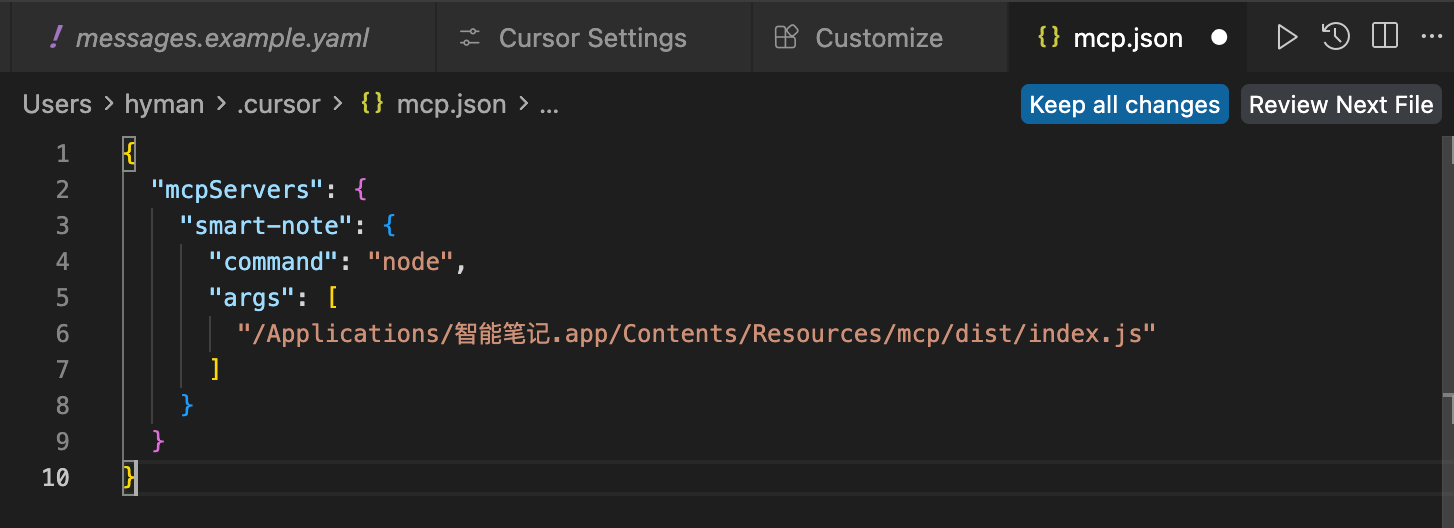
接入的成本倒是压到了最低:设置页里有一个「复制 MCP 配置」,粘进客户端就能连上。
# 最后
这三件事以前都不算「做不到」,只是太费手:查完的资料懒得搬、旧笔记不敢让 AI 改、想找的东西翻了半天。费手到一定程度,人就不做了。
现在的区别是,这些动作变得比不做还省事。顺手记一下,然后它真的在库里,而且搜得到。
而那篇设计文档,就是这个链路写进我的笔记本的。